HBF 重塑 AI 推理:高带宽闪存技术详解
AI 浪潮正在重塑的不只是 GPU 架构。
随着大模型规模持续增长,AI 基础设施越来越受到内存容量、带宽、成本和功耗的限制。GPU 可以提供极高的计算吞吐,但如何持续、高效地向计算单元供应模型参数和推理数据,已经成为整个行业最棘手的工程问题之一。
这一挑战通常被称为 “内存墙”(Memory Wall)。
高带宽内存(HBM)已经成为高性能 AI 加速器解决这一问题的核心方案,但 HBM 的成本高、容量有限。相比之下,NAND 闪存拥有极高的存储密度和更低的单位容量成本,却长期受制于带宽、延迟以及传统存储接口,难以直接融入加速器的高速内存层级。
High Bandwidth Flash(HBF,高带宽闪存) 正试图填补这一空白。
HBF 将高密度 3D NAND 闪存与受到 HBM 启发的先进堆叠、封装和并行互连技术结合起来。它不再让 NAND 只是位于 PCIe 或传统 SSD 控制器之后的远端存储,而是试图将大容量闪存直接拉近计算引擎,同时大幅提升整体并行带宽。
因此,HBF 并不是 HBM 的替代品。
它更像是为快速增长的 AI 推理需求设计的一种全新内存层。
SK 海力士近期已经通过一种 HBM + HBF 混合架构展示了这一思路。该方案在英伟达 Blackwell 级 GPU 环境下进行模拟,由 8 组 HBM3E 和 8 组 HBF 组成,相比纯 HBM 配置,单位功耗性能最高提升 2.69 倍。
随着 SK 海力士、三星和闪迪加速研发、商业化和标准化进程,HBF 正快速从研究概念走向 AI 基础设施。
🧠 为什么 AI 需要新的内存层 #
现代 AI 系统面临的瓶颈并不只是 FLOPS。
大型模型需要大量内存来保存:
- 模型权重
- Attention 状态
- Key-Value Cache
- 中间激活值
- Embedding 表
- 推理数据
- 检索数据
这个问题在 AI 推理阶段尤其明显。
一个大模型可能需要数百 GB,甚至数 TB 的存储空间,而 AI 加速器又需要快速、持续地访问这些参数。
当前内存层级存在明显的断层:
最低延迟 / 最高成本
          │
          ▼
        寄存器
          │
          ▼
       SRAM Cache
          │
          ▼
          HBM
          │
          ▼
      DDR / 系统内存
          │
          ▼
      SSD / NAND
          │
          ▼
最高容量 / 最低成本
HBM 可以提供极高的带宽,但成本昂贵且容量有限。
SSD 则能够提供巨大的容量和较低成本,却距离计算流水线更远,并且带宽和延迟与 HBM 存在数量级差距。
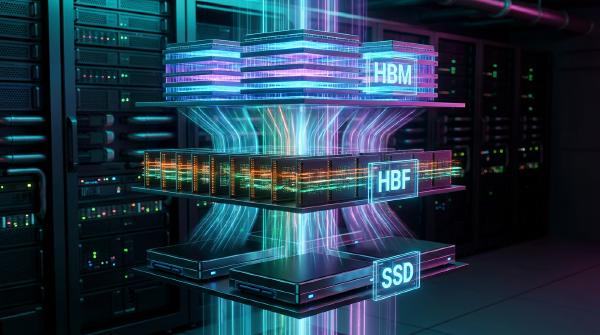
HBF 的目标,就是占据两者之间的新位置。
        高速计算
           │
           ▼
          HBM
     低延迟 / 高速缓存
           │
           ▼
          HBF
    高容量 / 高带宽
           │
           ▼
       SSD / NAND
    超大容量 / 低成本
它并不试图让 NAND 在所有维度上表现得像 DRAM,而是利用 NAND 极高的存储密度,同时将并行读取能力提升到足以让其更靠近 AI 计算核心。
⚡ HBF 如何实现高带宽闪存 #
HBF 的核心包含两个关键概念:3D NAND 高密度堆叠和大规模并行访问。
传统 NAND 本身已经采用高度垂直集成的结构,在单颗器件内部可以堆叠数百层 3D NAND 存储单元。
HBF 则进一步利用先进封装技术,将多个 NAND Die 进行高密度堆叠,并采用类似 HBM 的高速互连方式。
HBM 式垂直堆叠 #
第一个核心思路来自 HBM。
传统存储设备通常依赖有限数量的外部通道连接多个存储封装,而 HBF 则通过垂直堆叠多个 Die 来提升集成密度,并缩短芯片内部的数据传输路径。
概念上可以表示为:
传统 NAND / SSD 架构

Controller ── Channel ── NAND Package
                   │
                   └──── NAND Package
                   │
                   └──── NAND Package


HBF 架构

       ┌───────────────┐
       │   NAND Die    │
       ├───────────────┤
       │   NAND Die    │
       ├───────────────┤
       │   NAND Die    │
       ├───────────────┤
       │   NAND Die    │
       └───────────────┘
          高密度互连
垂直集成可以提升封装密度,并为更宽的数据通路建立物理基础。
但仅仅堆叠 NAND Die 并不能解释 HBF 的带宽潜力。
真正关键的是 NAND 阵列的并行访问方式。
大规模并行 Sub-Array 架构 #
传统 NAND 的并行能力受到通道数量以及内部访问结构的限制。
HBF 则尝试将闪存核心划分为大量可以独立工作的存储 Sub-Array。
不同 Sub-Array 可以并行执行读取和写入操作。
其核心架构可以简化为:
传统 NAND

        Controller
            │
       有限通道数量
       ┌────┼────┐
       ▼    ▼    ▼
      Die  Die  Die


HBF

       宽并行接口
  ┌────┬────┬────┬────┬────┐
  ▼    ▼    ▼    ▼    ▼    ▼
 Sub  Sub  Sub  Sub  Sub  Sub
Array Array Array Array Array
  │    │    │    │    │    │
  ▼    ▼    ▼    ▼    ▼    ▼
     NAND 并行操作
这使 NAND 从主要围绕容量优化的存储介质,逐渐转向一种高度并行的数据源。
HBF 的目标并不是实现 DRAM 的所有特性。
它真正要做的是利用 NAND 的超高密度,同时通过大规模并行读取,提高聚合吞吐量,使 NAND 可以更靠近 AI 加速器。
📊 HBF 与 HBM:容量与延迟的取舍 #
HBF 和 HBM 解决的是不同问题。
当 AI 加速器需要极低延迟、高写入性能以及可预测的高速访问时,HBM 依然是更合适的技术。
HBF 则牺牲部分延迟和写入能力,换取更大的容量以及更低的单位容量成本。
| 特性 | HBM | HBF |
|---|---|---|
| 存储技术 | DRAM | 3D NAND 闪存 |
| 核心优势 | 低延迟、极高带宽 | 高容量、高并行带宽 |
| 容量 | 相对有限 | 潜力显著更高 |
| 单位 GB 成本 | 高 | 潜力更低 |
| 读取性能 | 极高 | 针对高吞吐读取优化 |
| 写入性能 | 极高 | 更受限制 |
| 写入耐久度 | 适合高频内存访问 | 相比 DRAM 更有限 |
| 延迟 | 极低 | 高于 HBM |
| AI 主要角色 | 活跃计算与高速缓存 | 模型存储和读取密集型推理 |
| 与对方关系 | — | HBM 的补充方案 |
因此,理解 HBF 的关键就在于这一点:
HBF 并不是要取代 HBM,而是要扩大 AI 系统可使用的高速大容量内存空间。
🔥 为什么 HBF 特别适合 AI 推理 #
AI 推理与 AI 训练具有明显不同的内存访问特征。
训练阶段会持续更新模型参数,因此需要大量读写操作。
推理阶段则更加偏向读取。训练完成后的模型权重通常保持不变,而推理过程会反复访问这些权重。
这种访问模式与 NAND 的特点天然匹配。
读取密集型工作负载更适合 NAND #
模型加载完成后,其权重通常不会频繁修改。
典型流程可以表示为:
加载模型
   │
   ▼
读取模型参数
   │
   ▼
执行推理
   │
   ▼
再次读取参数
   │
   ▼
生成输出
这降低了 NAND 写入限制的重要性。
相关方案中提到 HBF 的写入耐久度约为 100,000 次循环。虽然相比 DRAM 仍然存在明显限制,但对于以读取为主、模型权重相对静态的 AI 推理场景而言,这种特性可能是可以接受的。
因此,软件必须理解底层内存层级。
AI Runtime 不能简单地把 HBF 当成无限容量的 DRAM 使用。
数据放置策略需要考虑:
- 读取频率
- 写入频率
- 访问局部性
- 延迟敏感程度
- 带宽需求
- 写入耐久度
🧩 H³ 混合内存架构 #
SK 海力士提出的一个重要方向,是将 HBM 与 HBF 放在 GPU 附近组成混合内存架构。
这一方案被称为 H³,本质上代表一种异构高带宽内存层级。
相关 IEEE 研究中的架构包含:
- 8 组 HBM3E
- 8 组 HBF
- 基于 Nvidia Blackwell B200 的 GPU 模拟环境
两种内存分别承担不同职责。
                AI 加速器
                    │
          ┌─────────┴─────────┐
          ▼                   ▼
         HBM                 HBF
     低延迟内存层         高容量内存层
          │                   │
          ▼                   ▼
    活跃工作数据          模型参数
    高频访问数据          大规模数据
    延迟敏感数据          容量扩展
HBM 充当高速工作内存。
HBF 则提供更大的模型和数据存储空间。
相关模拟结果显示,相比纯 HBM 配置,该架构的单位功耗性能最高可提升 2.69 倍。
实际收益当然会高度依赖具体工作负载和内存管理策略,但这一结果证明了异构内存体系对于 AI 推理具有明显潜力。
🏢 数据中心推理与边缘 AI #
HBF 的应用范围可能覆盖 AI 基础设施的两个方向。
数据中心中的容量扩展 #
在数据中心中,最直接的用途是扩展 AI 加速器能够访问的有效内存容量。
并不是所有模型参数都必须放入昂贵的 HBM。
一种更合理的架构是:
- 将延迟敏感、频繁访问的数据放入 HBM
- 将大规模、读取密集型的数据放入 HBF
- 将冷数据和长期数据放入 SSD
这样可以形成分层的加速器存储体系:
GPU 计算
    │
    ▼
┌───────────────┐
│      HBM      │
│   活跃 / 热数据 │
│  高频访问数据   │
└───────┬───────┘
        │
        ▼
┌───────────────┐
│      HBF      │
│    模型权重    │
│  大容量 / 温数据 │
└───────┬───────┘
        │
        ▼
┌───────────────┐
│  SSD / Storage │
│   冷数据 / 归档 │
└───────────────┘
这种架构可以让 AI 加速器访问更大的模型,而不需要按相同比例增加昂贵的 HBM 容量。
边缘 AI #
HBF 同样适合边缘推理。
边缘 AI 通常运行已经训练完成的模型,这些模型在实际部署过程中并不会频繁修改。
这与 HBF 的优势高度匹配:
- 高读取带宽
- 大容量
- 更低的单位容量成本潜力
- 相对较低的功耗
潜在应用包括:
- 边缘 AI 推理服务器
- AI 一体机
- 机器人系统
- 自动驾驶与自主系统
- 企业 AI 设备
- 私有 AI 部署
如果大型模型可以直接存储在靠近本地计算的位置,企业对远程云端推理的依赖也可能进一步降低。
🚧 HBF 商业化面临哪些挑战 #
HBF 的概念非常有吸引力,但真正实现商业化远不只是把 NAND Die 堆叠起来。
NAND 与 DRAM 在底层工作方式上存在根本差异。
HBF 需要同时解决:
- 高密度互连
- 封装散热
- 信号完整性
- 并行访问调度
- 地址转换
- 写入管理
- 写入耐久度
- ECC
- 控制器设计
- 内存一致性
- 软件数据放置
NAND 的地址访问粒度不同 #
其中一个重要挑战来自 NAND 较粗粒度的访问机制。
DRAM 从设计之初就针对高频、细粒度随机访问进行了优化。
NAND 则围绕 Page 和 Block 等更粗粒度的数据结构运行,同时存在复杂的 Program 和 Erase 行为。
因此,HBF 控制器和软件栈需要在 AI 加速器的访问模型与底层 NAND 机制之间建立抽象层。
AI 加速器访问
      │
      ▼
细粒度内存请求
      │
      ▼
 HBF Translation Layer
      │
      ▼
NAND 并行 Sub-Array
      │
      ▼
Pages / Blocks / Flash Cells
系统必须同时向加速器提供足够高的带宽,并在底层高效管理 NAND 的固有特性。
写入耐久度要求软件协同 #
写入耐久度是另一个基础限制。
HBF 不适合被当作普通 Scratchpad,持续写入大量动态数据。
更加合理的数据放置方式可能是:
频繁修改的数据
        │
        ▼
       HBM


高频读取、低频修改的数据
        │
        ▼
       HBF


持久化 / 冷数据
        │
        ▼
    SSD / Storage
因此,HBF 能否成功商业化,部分取决于 AI Runtime 是否能够真正理解异构内存。
仅靠硬件无法解决 Memory Wall。
软件栈同样必须知道数据应该存在哪里。
📈 HBF 的容量与带宽潜力 #
HBF 最重要的优势之一就是容量。
相关方案预计 HBF 单个器件的容量可以达到约 512 GB,明显高于这里引用的 HBM4 64 GB 级别容量。
与此同时,HBF 的带宽也有望远高于传统 SSD。
目前公布的相关设计目标已经超过 1,638 GB/s。
这并不意味着 HBF 就等同于 HBM。
带宽只是内存性能的一项指标。延迟、访问粒度、写入行为以及软件开销同样重要。
不过,这些数字很好地解释了为什么 HBF 正受到 AI 行业关注。
传统 SSD
      │
      │ 超大容量
      │ 较低带宽
      ▼

      HBF
      │
      │ 超大容量
      │ 高并行带宽
      ▼

      HBM
      │
      │ 较低容量
      │ 极高带宽
      │ 极低延迟
      ▼
HBF 因此创造了一个新的容量与性能平衡点。
🏭 HBF 正从研究走向商业化 #
HBF 的研发速度正在明显加快。
SK 海力士、三星和闪迪正在通过存储芯片、先进封装、控制器以及生态合作共同推进这项技术。
闪迪计划在 2026 年下半年提供 HBF 样品,而面向 AI 推理的首批 HBF 产品预计在 2027 年初进入市场。
SK 海力士同样计划在 2026 年下半年推出试用版本,而主要厂商的商业 HBF 产品预计将在 2027 年逐步出现。
目前的商业化时间线大致可以表示为:
| 时间 | 预期进展 |
|---|---|
| 2026 年下半年 | 初期 HBF 样品和试用产品 |
| 2026 年起 | 架构验证与生态建设 |
| 2027 年初 | 首批 AI 推理 HBF 产品 |
| 2027 年 | 更广泛的商业 HBF 产品 |
与此同时,行业也在推动 HBF 标准化。
这一点非常重要。
如果不同厂商采用完全不同的接口、封装、控制器和软件体系,HBF 很难成为真正的 AI 基础设施标准。
未来需要建立跨产业链的兼容生态,包括:
- 存储芯片厂商
- AI 加速器厂商
- 先进封装厂商
- 控制器厂商
- 服务器厂商
- AI Runtime 开发者
🔮 HBF 与 Memory-Centric AI 的未来 #
过去数年,AI 加速器的发展重点主要集中在提升计算吞吐量。
但随着模型规模不断扩大,计算能力越来越容易受到内存容量和数据移动效率的限制。
如果 GPU 无法及时获得模型参数,那么再高的计算单元吞吐量也无法得到充分利用。
这正是 AI 基础设施开始采用更加专用化内存架构的原因。
HBM 主要解决带宽问题。
HBF 则试图解决容量问题,同时保留高并行带宽。
未来的 AI 内存体系可能并不是由某一种技术统一完成,而是形成更加复杂的异构内存层级:
最高速 / 最高成本
        │
        ▼
    On-Chip SRAM
        │
        ▼
       HBM
        │
        ▼
       HBF
        │
        ▼
    SSD / NAND
        │
        ▼
最低速 / 最高容量
每一层负责不同的任务。
真正的挑战将变成:
如何在正确的时间,把正确的数据放到正确的内存层。
这正是 Memory-Centric AI 的核心。
🚀 HBF 不会取代 HBM,而是扩展 AI 内存 #
理解高带宽闪存最重要的一点,就是不要把 HBF 看成一种廉价版 HBM。
两者的目标完全不同。
HBM 仍然适合极低延迟、高频写入和最大化计算核心附近带宽的工作负载。
HBF 则瞄准昂贵的加速器内存与传统存储之间巨大的空白区域。
通过结合 3D NAND 的高密度存储能力、先进垂直堆叠以及大规模并行访问,HBF 有望为 AI 系统提供一种全新的高容量内存层,让更大的模型能够以更高带宽直接靠近计算引擎。
对于 AI 推理而言,这种组合尤其具有吸引力。
模型规模不断扩大,而推理阶段主要以读取模型参数为主;与此同时,无限制地增加 HBM 容量的成本正在快速上升。
因此,未来很可能形成一种更加明确的分工:
HBM 负责速度,HBF 负责容量,SSD 负责持久化存储。
如果行业能够解决 NAND 地址访问、写入耐久度、先进封装、互连以及软件内存管理等问题,HBF 很可能成为未来 AI 内存体系中的重要一层。
Memory Wall 不会因此消失。
但 HBF 有可能在这堵墙上增加一个全新的台阶,让 AI 加速器拥有更大的模型空间和更高效的数据访问路径。